


Twitch i Amazon pozwane za trenowanie AI na treściach streamerów bez ich zgody
W połowie sierpnia Twitch zapowiedział, że wszystkie treści znajdujące się na ich platformie staną się częścią zbiorów treningowych dla modeli generatywnej AI. Jak można się domyślić, reakcje nie były zbyt pozytywne…

Twitch mierzy się z dość sporym kryzysem wizerunkowym po tym, jak firma zapowiedziała, że wszystkie treści znajdujące się na platformie wesprą trening modeli genAI firmy-matki platformy, Amazona. Do głośnych sprzeciwów w mediach społecznościowych dołączył niedawno również pozew złożony w stanie Kalifornia. Z czego wynika całe to zamieszanie i czy sprawa sądowa coś zmieni?
„Jeśli trzeba byłoby się zgadzać, nikt by się nie zgodził”
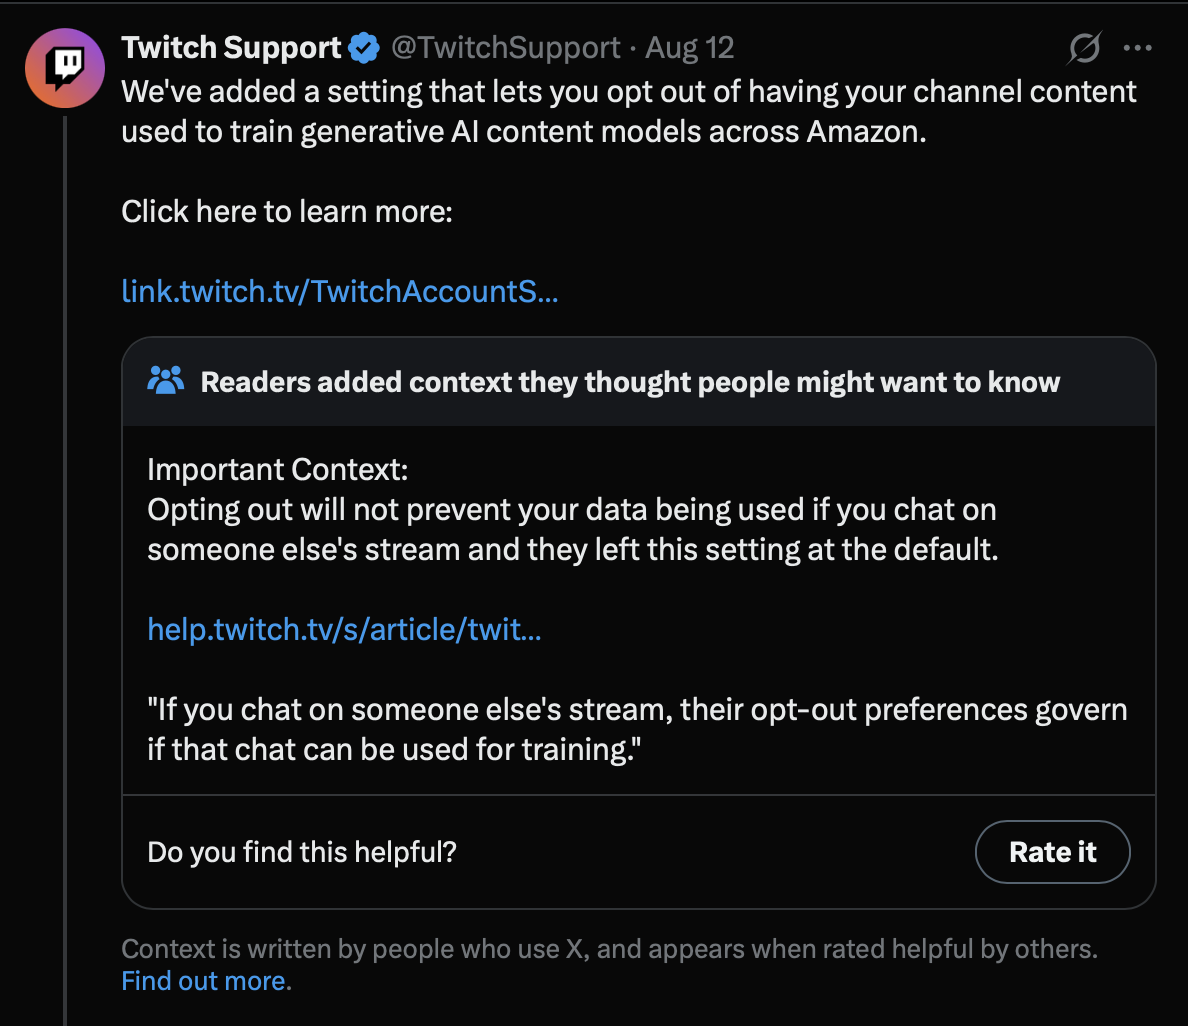
Cała historia zaczęła się 12 sierpnia, kiedy Twitch zapowiedział dodanie nowego ustawienia w panelu użytkownika, które pozwalało wycofać zgodę na udostępnienie treści stworzonych przez użytkownika w celu trenowania modeli AI Amazona. Tak, dobrze widzicie – wycofanie zgody.
Domyślnym założeniem firmy było to, że każdy się na to zgadza. Takie podejście nie jest niczym nowym wśród gigantów technologicznych – w lipcu głośno było o podobnej sytuacji ze zgodami w przypadku generatora Muse Image, o czym więcej przeczytacie w tekście Mateusza. Jednakże, tak czy inaczej takie zagrania nie były i nie są akceptowane przez społeczność, stąd tak mocna reakcja.
Oliwy do ognia dolała również wypowiedź szefu działów produktów Twitcha, Mike’a Mintona, który powiedział wprost: „Jeśli trzeba byłoby się zgadzać, nikt by się nie zgodził”. Jego zdaniem, większość platform z treściami zakłada, że użytkownik się zgadza na udostępnianie swoich treści, a to, że Twitch pozwala się wycofać, jest gestem dobrej woli wobec ludzi.

Twitch i Amazon pozwane
Te swoiste „pójście na rękę” nie zdało się na nic, gdyż zarówno Twitch, jak i jego właściciel Amazon zostały pozwane przez jednego z użytkowników platformy. Walter Pandiscia, streamer z ponad 900 obserwującymi oskarża obydwie firmy o bezprawne kopiowanie milionów filmów w celu rozwoju produktów i modeli AI firmy Amazon, łamiąc tym samym umowy z samymi twórcami treści oraz stanowe przepisy dotyczące konkurencji.
Zdaniem pozywającego, firmy korzystały ze swojej pozycji i korzystały z treści opublikowanych na platformie w celach treningowych bez zgody ich twórców już w 2024 roku, aby w późniejszym terminie dostosować politykę prywatności tak, aby dane użytkowników były odpowiednio mniej chronione.
Zdaniem Mike’a Mintona, pełniącego wtedy rolę szefa działu monetyzacji, pozyskane materiały były wykorzystywane w procesie prototypowania różnorodnych rozwiązań AI i tylko w granicach prawa. Obecnie jednak, Twitch nie kryje się z tym, że materiały są wykorzystywane do treningu modeli generujących tekst, dźwięk, zdjęcia czy filmy oraz do rozwoju narzędzi do automatycznego generowania napisów, pisząc o tym wprost w sekcji FAQ.
Pożeracze treści
Sytuacja z trenowaniem AI na podstawie treści z Twitcha to kolejny przykład tego, do czego zdolne są korporacje, kiedy stawką jest dominacja w nowym sektorze. Każdy chce stworzyć najlepszy model, a do tego są potrzebne coraz większe ilości danych treningowych. Giganci tacy jak OpenAI, Anthropic czy Amazon są gotowi łamać polityki prywatności, ignorować zgody i umowy licencyjne czy też dosłownie niszczyć rzadkie książki tylko po to, aby ich model radził sobie jeszcze lepiej, pożerając przy tym jeszcze więcej energii i innych zasobów.
Najgorsze w tym wszystkim jest to, że giganci są w tym często bezkarni, częściowo z uwagi na to, że trudno jest im udowodnić winę, a częściowo dlatego, że z prawnego punktu widzenia, nie łamią żadnych przepisów. Wiele platform zmieniło swoje polityki prywatności tak, aby mogły one w pełni korzystać z danych właśnie w takich celach bez płacenia ani grosza dla osób, które zapewniają im treści do treningu AI. Użytkownik nie ma tutaj nic do gadania — zgodził się na te warunki, akceptując regulamin przy logowaniu.
Wciągnięcie naszych danych i stworzonych przez nas treści do zbiorów treningowych jest na swój sposób nieunikniony, bo nawet jeśli nie wyrazimy na to zgody, kreatywna interpretacja prawa i regulaminów sprawi, że giganci technologiczni i tak dopną swego.
Nie zmienia to jednak faktu, że możemy stawiać opór, podchodząc bardziej świadomie do naszej aktywności w sieci albo głośno mówiąc o wszelkiego rodzaju naruszeniach dokonywanych przez firmy. Kto wie, może uda się w ten sposób coś zmienić?

